 Telegram
 Facebook
 Instagram
 YouTube
 info@osintlaw.com
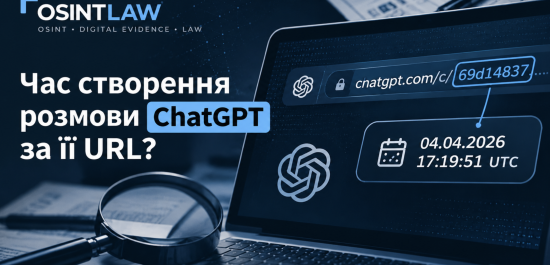
Виявляється, у посиланні на розмову ChatGPT зашито час, коли її створили — і прочитати його можна, навіть не відкриваючи саму розмову. Що це за метод, наскільки йому можна довіряти і де межа між технічною знахідкою та доказом у суді.
Виявляється, у звичайному посиланні на розмову ChatGPT зашито час, коли її створили. Прочитати його можна, навіть не відкриваючи саму розмову і не маючи доступу до її змісту — достатньо самого URL. Про це наприкінці жовтня написав Ryan Benson, розробник криміналістичних інструментів Hindsight і Unfurl. Нижче — як працює метод, чому йому можна (частково) довіряти і що з ним робити юристу.
Benson зібрав близько 284 тисяч посилань на розмови ChatGPT — з Wayback Machine, Common Crawl і власного архіву URL — і придивився до їхньої структури. Виявилося, що формат ідентифікаторів змінювався. До кінця серпня 2024 року ChatGPT використовував UUIDv4 — суто випадкові ідентифікатори, у яких часу немає. А з 30 серпня 2024 року перейшов на UUIDv8, і ось у ньому час уже є.
Трохи технічного контексту. UUID — це 128-бітний ідентифікатор, яким програми позначають об’єкти. Восьма версія стандарту тим і особлива, що дозволяє розробнику напхати в неї що завгодно на власний розсуд. OpenAI цим скористалася — і, схоже, поклала туди часову мітку. Кажу «схоже», бо офіційно компанія формат не описувала: усе, що ми знаємо, — результат зворотного аналізу. Це перше, що треба тримати в голові.
Візьмемо реальний приклад із дослідження: https://chatgpt.com/c/69d14837-c894-83e8-be51-203e72906522. Ідентифікатор розмови тут — 69d14837-c894-83e8-be51-203e72906522. Увесь фокус — у перших восьми символах: 69d14837. Це Unix timestamp, записаний у шістнадцятковій системі. Переводимо в десяткову — отримуємо 1775323191, тобто 4 квітня 2026 року, 17:19:51 UTC. Усе. Жодного доступу до повідомлень, жодного відкриття посилання — лише текст URL.
Декодувати число — легко. Складніше довести, що це справді час створення, а не випадковий збіг. Тут у Benson елегантний хід: він узяв Wayback Machine. Логіка очевидна — сторінку не можна заархівувати раніше, ніж вона з’явилася. Тож якщо мітка з ідентифікатора справжня, вона має бути раніше за першу архівну копію. Він прогнав через цю перевірку понад 180 тисяч ідентифікаторів. У переважній більшості мітка справді передувала архівуванню, а медіанна різниця склала всього 71 секунду — тобто розмови архівувалися майже одразу після створення. Були й поодинокі аномалії, тому я б формулював обережно: це сильна емпірична перевірка, а не гарантія, що формат ніколи не зміниться.
Перевірити самому нескладно. Берете ідентифікатор, відрізаєте перші вісім символів і переводите їх із шістнадцяткової системи в дату. У Python це чотири рядки:
from datetime import datetime, timezone

conversation_id = "69d14837-c894-83e8-be51-203e72906522"
timestamp = int(conversation_id[:8], 16)
created_at = datetime.fromtimestamp(timestamp, tz=timezone.utc)
print(created_at.isoformat())
На виході — 2026-04-04T17:19:51+00:00.
Але є пастка, і для юриста вона критична. Перш ніж довіряти отриманій даті, треба переконатися, що перед вами справді ChatGPT-івський UUIDv8, а не схожий рядок. Бо будь-який випадковий UUID теж «розшифрується» в якусь дату — правдоподібну на вигляд і цілком безглузду по суті. Benson відсіює такі збіги за кількома ознаками одразу: версія 8, два нульові біти в полі суб-секунди, значення поля node у характерних діапазонах і наявність дефісів. Пропустити цю перевірку — найлегший спосіб зробити красивий, але хибний висновок.
Крім часу, в ідентифікаторі є ще кілька полів: частки секунди, номер версії, 12-бітне поле, яке автор назвав node, і випадковий «хвіст». Benson припускає, що node — це якийсь сервер, кластер чи сегмент інфраструктури OpenAI, але сам же наголошує: це здогад, а не факт. І саме тут проходить межа, яку в юридичному тексті не можна розмивати: одне діло — підтверджений час, інше — гіпотеза про призначення поля. Видавати друге за перше не можна.
До речі, метод працює не лише з розмовами. Та сама логіка знайшлася в ідентифікаторах окремих GPT, проєктів та об’єктів API. А для ідентифікаторів Chat Completions API (ті, що починаються з chatcmpl-) діє інша схема кодування часу — Benson звірив її на 152 відповідях API і влучив у 150. Щоправда, це справедливо лише для «рідних» ідентифікаторів OpenAI: сторонні сервіси, сумісні з її API, можуть мати власні формати.
Навіщо все це юристу. Посилання на ChatGPT сьогодні трапляються всюди — у соцмережах, на GitHub, у документах, в архівах сторінок, у журналах браузера. І кожне таке посилання тепер несе ще й дату. Найочевидніше — зіставляти її з хронологією. Людина каже, що розмова була такого-то числа, а мітка в посиланні каже інше — це не вирок, але привід поставити питання. Так само можна звіряти час розмови з датою публікації документа чи архівування сторінки, добудовуючи послідовність подій. А під час роботи з історією браузера чи логами доступу URL раптом стає не просто адресою, а датованою позначкою.
По суті це той самий підхід, який ми відстоюємо постійно: у матеріалі про ідентифікатори юридичних осіб я писав, що код майже завжди надійніший за те, що видно на поверхні. Тут — рівно те саме, тільки замість коду компанії час розмови.
А тепер найважливіше — чи спрацює це в суді. Тут доведеться пригальмувати. Технічна можливість дістати дату — це одне, а її процесуальна вага — зовсім інше. Декодована мітка сама собою не підтверджує ні змісту розмови, ні її автора, ні того, що повідомлення не змінювали. Щоб вона взагалі про щось говорила в процесі, доведеться відповісти на кілька незручних питань. Звідки взявся URL і чи зберігся первинний носій, де він був. Чи не редагували ідентифікатор після отримання. Чи правильно визначено формат і чи відтворюється результат. Що саме позначає ця дата — створення розмови чи якусь іншу технічну подію. І головне — чи має вона взагалі стосунок до того, що ви доводите.
У наших реаліях це лягає в дослідження електронних доказів за статтями 84, 86, 93 і 99 КПК. Але допустимість і сила визначаються не фактом декодування UUID, а походженням матеріалу, способом його отримання й зв’язком зі справою. Тому ні — саме по собі посилання на ChatGPT судовим доказом не стає. Як правильно фіксувати такі знахідки, щоб вони взагалі мали шанс, — у статті «Скріншот як доказ у суді».
І варто чесно назвати, чого метод не вміє — це рятує від спокуси перебільшити. Мітка не скаже, хто створив розмову, які повідомлення в ній були спочатку, чи змінювали їх потім, чи писала це людина, чи машина, і чи взагалі ця розмова належить конкретній особі. Ба більше: UUID — не підпис. Ніщо не заважає згенерувати рядок правильної структури й вписати в нього будь-яку дату. Тож ідентифікатор сам собою не доводить навіть того, що розмова реально існувала в ChatGPT у вказаний момент. Для серйозного висновку потрібне незалежне підтвердження — логи, історія браузера, архівна копія, інші сліди, що сходяться між собою.
Робота Benson цінна навіть не самою знахідкою, а тим, як він її перевірив — на великому масиві, через незалежне джерело. Для OSINT це ще один спосіб датувати цифровий об’єкт, для криміналіста — новий тип артефакту, а для юриста — нагадування, що технічно правильний результат і доказ у справі це не одне й те саме. Якщо стисло: посилання на ChatGPT може підказати, коли розмову створили, але нічого не каже ні про її зміст, ні про автора. Знати цю межу — і є професіоналізм.
Матеріал має інформаційний характер і не є юридичною консультацією.
Потрібно перевірити автентичність цифрового доказу або вибудувати таймлайн подій? Послуги LawOSINT — звʼяжіться з нами.
Джерела
- Ryan Benson. Extracting Timestamps from ChatGPT IDs. Hindsight Foundry, 29 жовтня 2026 — hindsig.ht
- IETF. RFC 9562: Universally Unique IDentifiers (UUIDs) — rfc-editor.org
- Hindsight Foundry. Unfurl — URL Analysis Tool — hindsig.ht/tools
- Кримінальний процесуальний кодекс України, статті 84, 86, 93, 99
Прокурори анонімізували співучасників у справі Prince Group — а журналісти OCCRP встановили одного з них за деталями в самому обвинувальному акті. Розбираємо кейс і метод OSINT-деанонімізації: як особу викривають через зіставлення відкритих даних кількох юрисдикцій.
Знайти ім'я й фото підозрюваного легко — але оприлюднити їх до вироку майже не можна. Об'єднана палата КЦС ВС роз'яснила межі розкриття персональних даних підозрюваного (справа № 761/1004/20). Що це означає для OSINT-аналітиків, журналістів-розслідувачів і юристів.
Які схеми приховування майна викриває OSINT у 2025–2026: оформлення на родичів і підставних осіб, заниження вартості, «корпоративна вуаль», ланцюги посередників, закордон і крипта, фраудаторні правочини. Знеособлені кейси, червоні прапорці, межі методу й джерела.
Українське законодавство не знає поняття «OSINT», але Верховний Суд уже сформував сталу практику щодо допустимості доказів із відкритих джерел. Розбираємо ключові правові позиції ВП ВС і те, що вони означають для практика.
Berkeley Protocol on Digital Open Source Investigations — офіційний стандарт ООН (документ ST/HR/PUB/20/2), за яким МКС, ЄСПЛ і національні суди оцінюють OSINT-докази у 2026 році. Українською не перекладено. Розбираємо простою мовою: 5 базових принципів, 4 стовпи ланцюга зберігання, 9-крокова методологія роботи документатора, застосування у справах МКС проти Аль-Верфаллі, Путіна, Al Hassan. З конкретними прикладами SHA-256-хешування, шаблонами звітів і поясненням, чому без цього стандарту ваша робота залишається журналістикою, а не юридичним доказом.
26 липня 2026 року команда "Телебачення Торонто" опублікувала розслідування Анатолія Остапенка про життя Януковича у Росії — з новою особою "Олег Леонов", маєтком у Сочі, охороною ФСО. Розбираємо OSINT-методологію (сім шарів: витоки реєстрів, GetContact, авіаперельоти, соцмережі, підрядники, крос-верифікація, ідентифікація через оточення) з юридичного погляду: що допустимо як доказ, що — тільки як оперативна інформація, а що — сіра зона. З уроками для документаторів, адвокатів і прокурорів.
25 липня 2026 Телебачення Торонто опублікувало розслідування про життя Януковича і його родини в Росії. Ми не переказуємо історію — розбираємо методологію: витоки російських реєстрів, GetContact як реверс телефонних номерів, аналіз попутників у авіаперельотах, соцмережі підрядників як паралельне джерело, ідентифікація псевдонімів через дати народження і дівочі прізвища. Плюс — юридичний контекст для санкційного права, розшуку активів, ARMA, підготовки позовів. Практичний матеріал для юристів, які працюють з voidстанням шкоди від воєнної агресії.
17 березня 2023 року Міжнародний кримінальний суд видав перший в історії ордер на арешт чинного президента постійного члена Ради Безпеки ООН. Розбираємо, як Yale Humanitarian Research Lab через супутникові знімки, аналіз російських Telegram-каналів і публічних заяв самої Львової-Бєлової довели те, що Росія відкрито заперечувала. З верифікованою статистикою повернутих дітей станом на 2026, юридичним аналізом статей 8(2)(a)(vii) і 8(2)(b)(viii) Римського статуту і уроками для українських документаторів.
25 липня 2026 року на r/ClaudeAI з'явився пост, який показав: звичайний запит site:claude.ai/share повертає у Google сотні розмов інших людей з AI-асистентом Claude. API-ключі, реквізити криптогаманців, резюме, нотатки юриста, дані клінічних досліджень. Розбираємо, чому цей випадок принципово важливий для OSINT-методології, як він вписується у ширшу картину AI-платформ як нового класу відкритих джерел, які пошукові техніки працюють — і де межа між ефективним розслідуванням і юридично небезпечним використанням.
Справа Аль-Верфаллі — перший в історії Міжнародного кримінального суду ордер на арешт, виданий переважно на основі відео з Facebook і YouTube. Детальний розбір: контекст Лівії, сім інцидентів, роль Bellingcat у краудсорсинговій геолокації, юридичний аналіз стандарту "достатніх ознак автентичності", критика Emma Irving, другий ордер зі свідченнями свідків, значення прецеденту для сучасних справ МКС проти російського керівництва.
Що таке OSINT — простими словами для юриста, який чує це вперше. Розшифровка терміну, історія, реальні кейси з посиланнями на першоджерела: MH17 у ЄСПЛ, отруєння Скрипалів, справа Аль-Верфаллі в МКС, ордер проти Путіна, засудження Анвара Раслана в Кобленці, розшук санкційованих активів. З прикладами застосування у сімейних, кримінальних, господарських та санкційних справах.